Meta раскрыла устройство суперкластера на миллион GPU
Один GPU в кластере под нагрузкой потребляет 1400 Вт, а запуск или пауза большой задачи меняет потребление на десятки мегаватт за секунды.
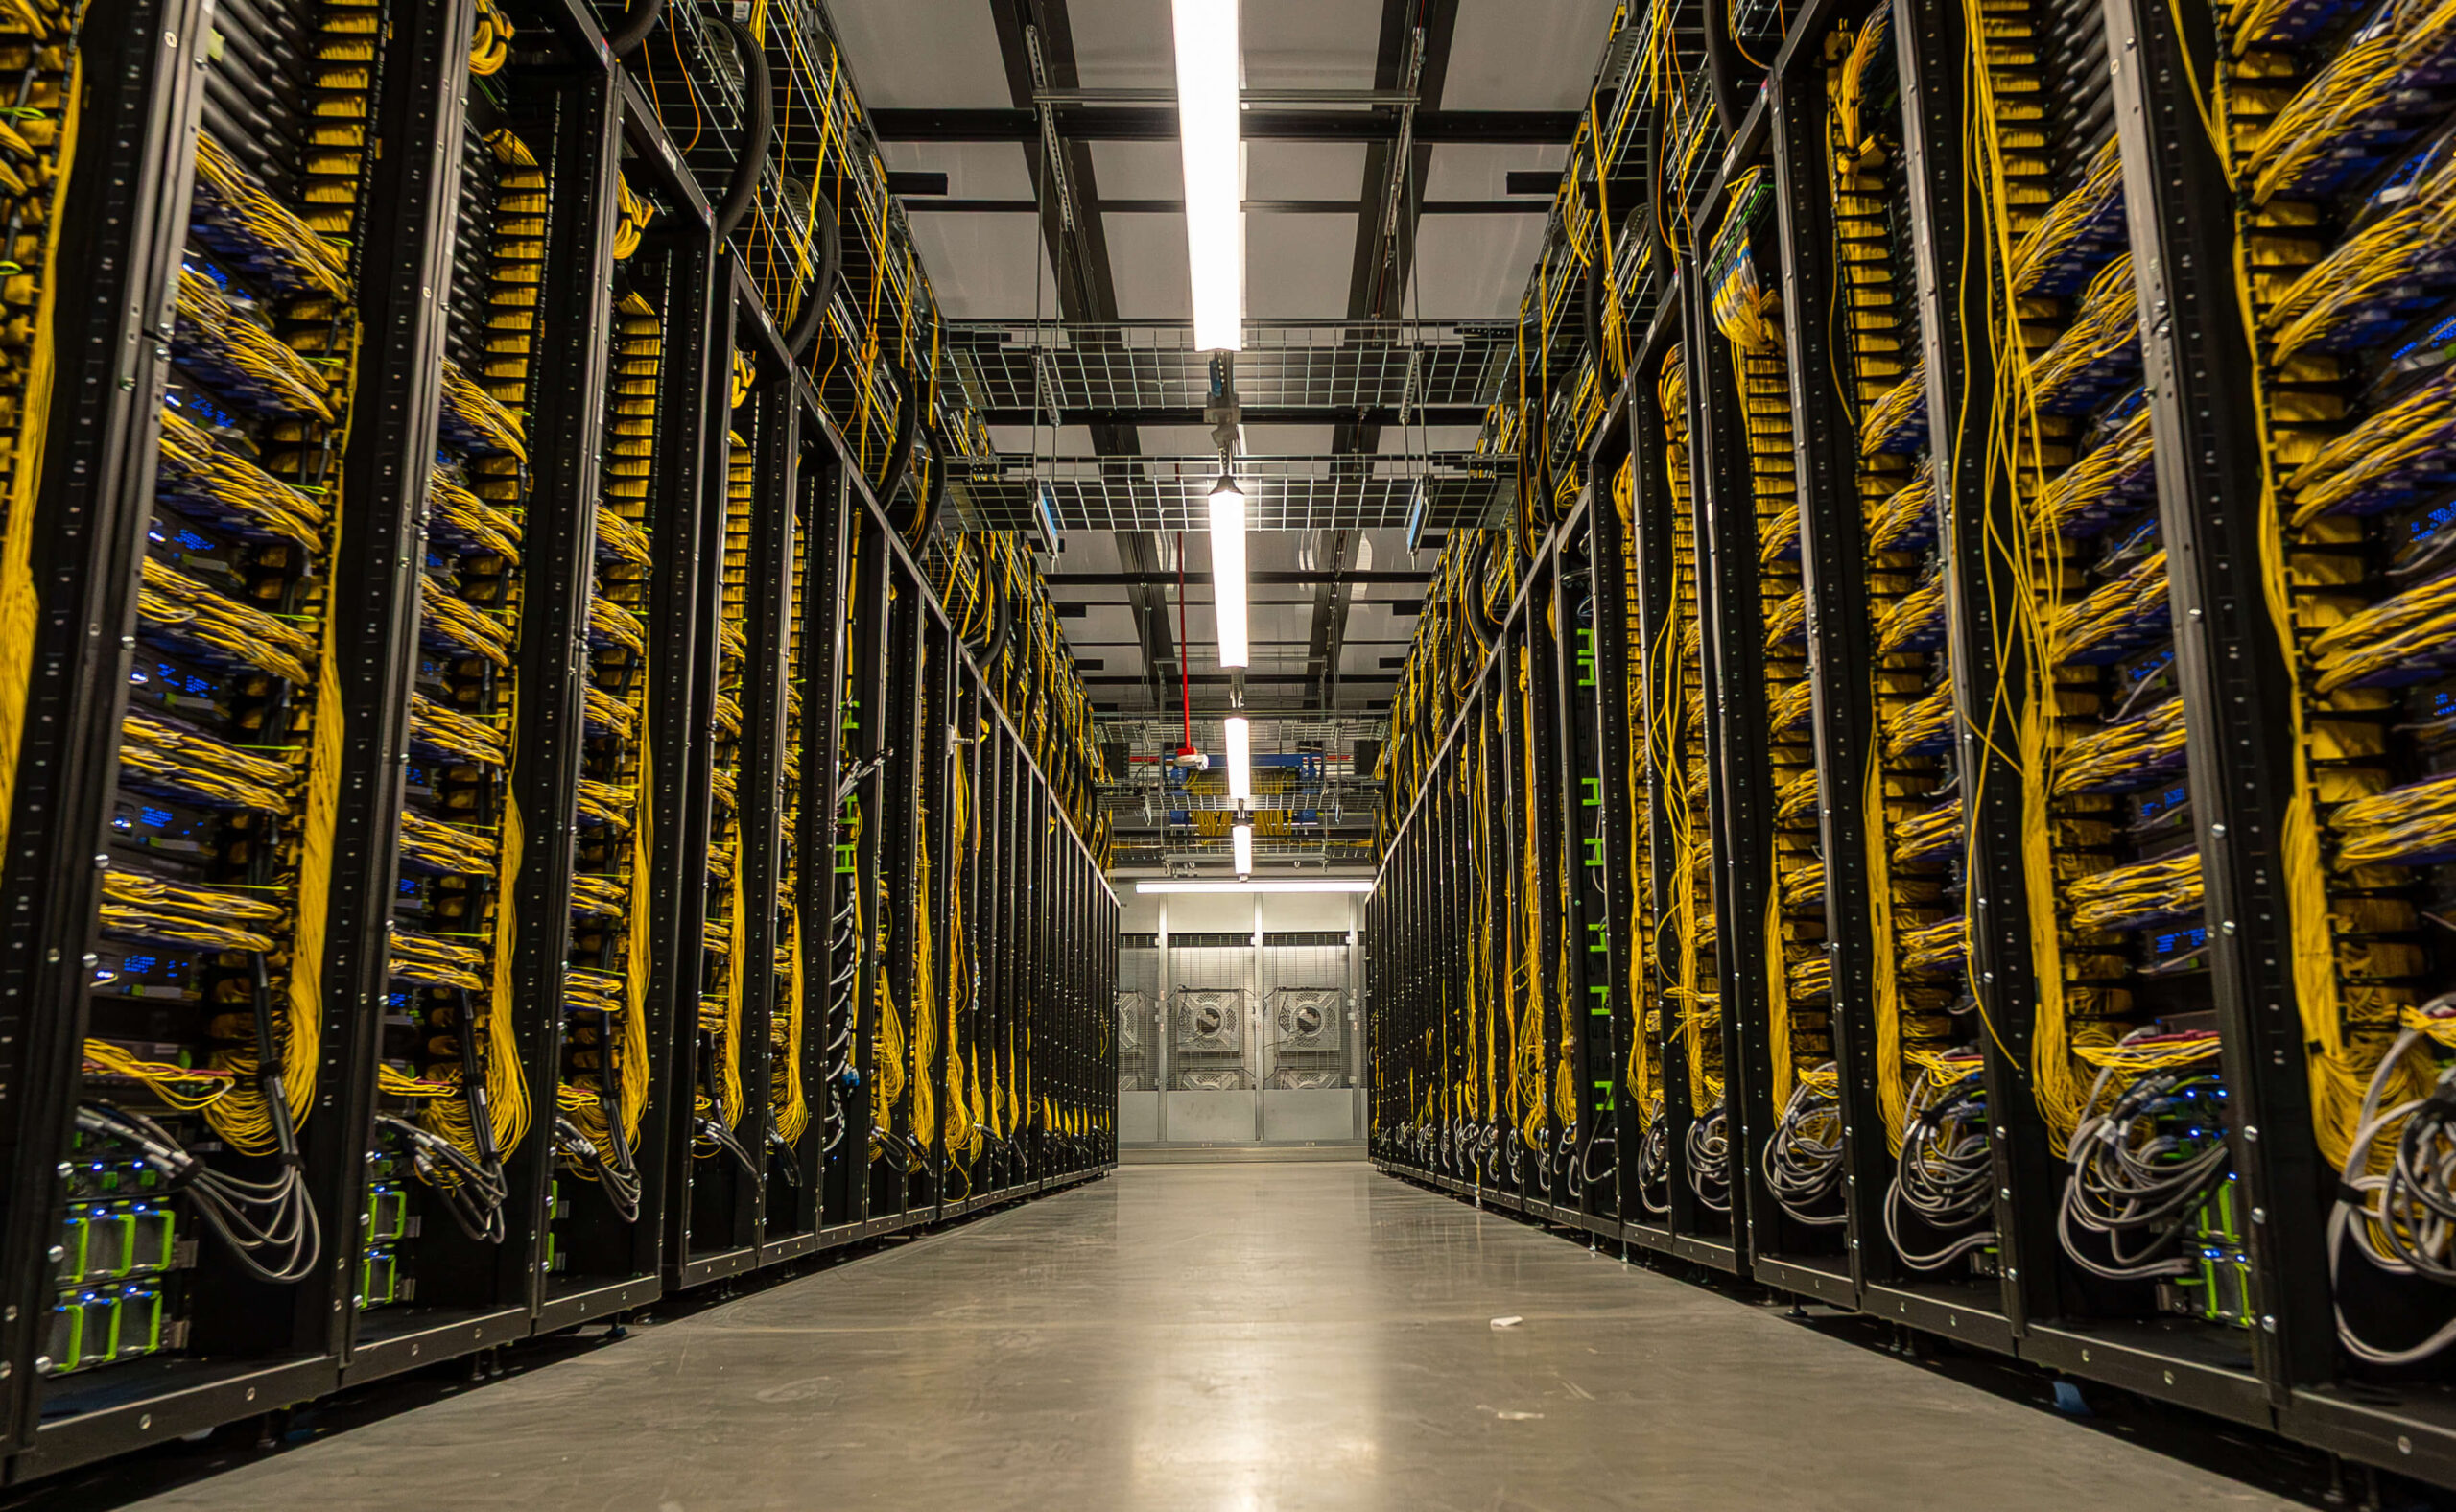
Фото: Meta
Meta впервые подробно описала Prometheus, свой суперкластер для обучения ИИ в Нью-Олбани, штат Огайо. Первая очередь уже работает, на ней обучали модели семейства Muse, включая флагманскую Muse Wonder. Сейчас в кластере сотни тысяч графических процессоров в нескольких связанных зданиях. В полном масштабе их будет около миллиона.
«В полном масштабе Prometheus будет включать примерно миллион распределённых GPU, которые работают синхронно», пишут инженеры компании в блоге Engineering at Meta. Мощность площадки измеряется гигаваттами. Два года назад на этом месте стоял обычный дата-центр для веб-трафика.
Из чего собран кластер
Основа Prometheus — стойки Nvidia на 72 GPU. Первая платформа, Catalina, построена на GB200 NVL72: 192 ГБ памяти HBM3e на каждый GPU и до 1440 петафлопс в вычислениях FP4. Вторая, Clemente, использует GB300 NVL72 с 288 ГБ памяти на процессор и производительностью выше одного экзафлопса. По оценке Meta, она быстрее GB200 на 5–10%.
Следующей станет платформа San Miguel на Nvidia Vera Rubin NVL72. В ней будет 288 ГБ памяти HBM4 на GPU, а одна стойка выдаст 2,52 экзафлопса в FP4. Энергоэффективность, по данным Meta, вырастет на 10–20% к GB300, но стойка будет потреблять больше 170 кВт.
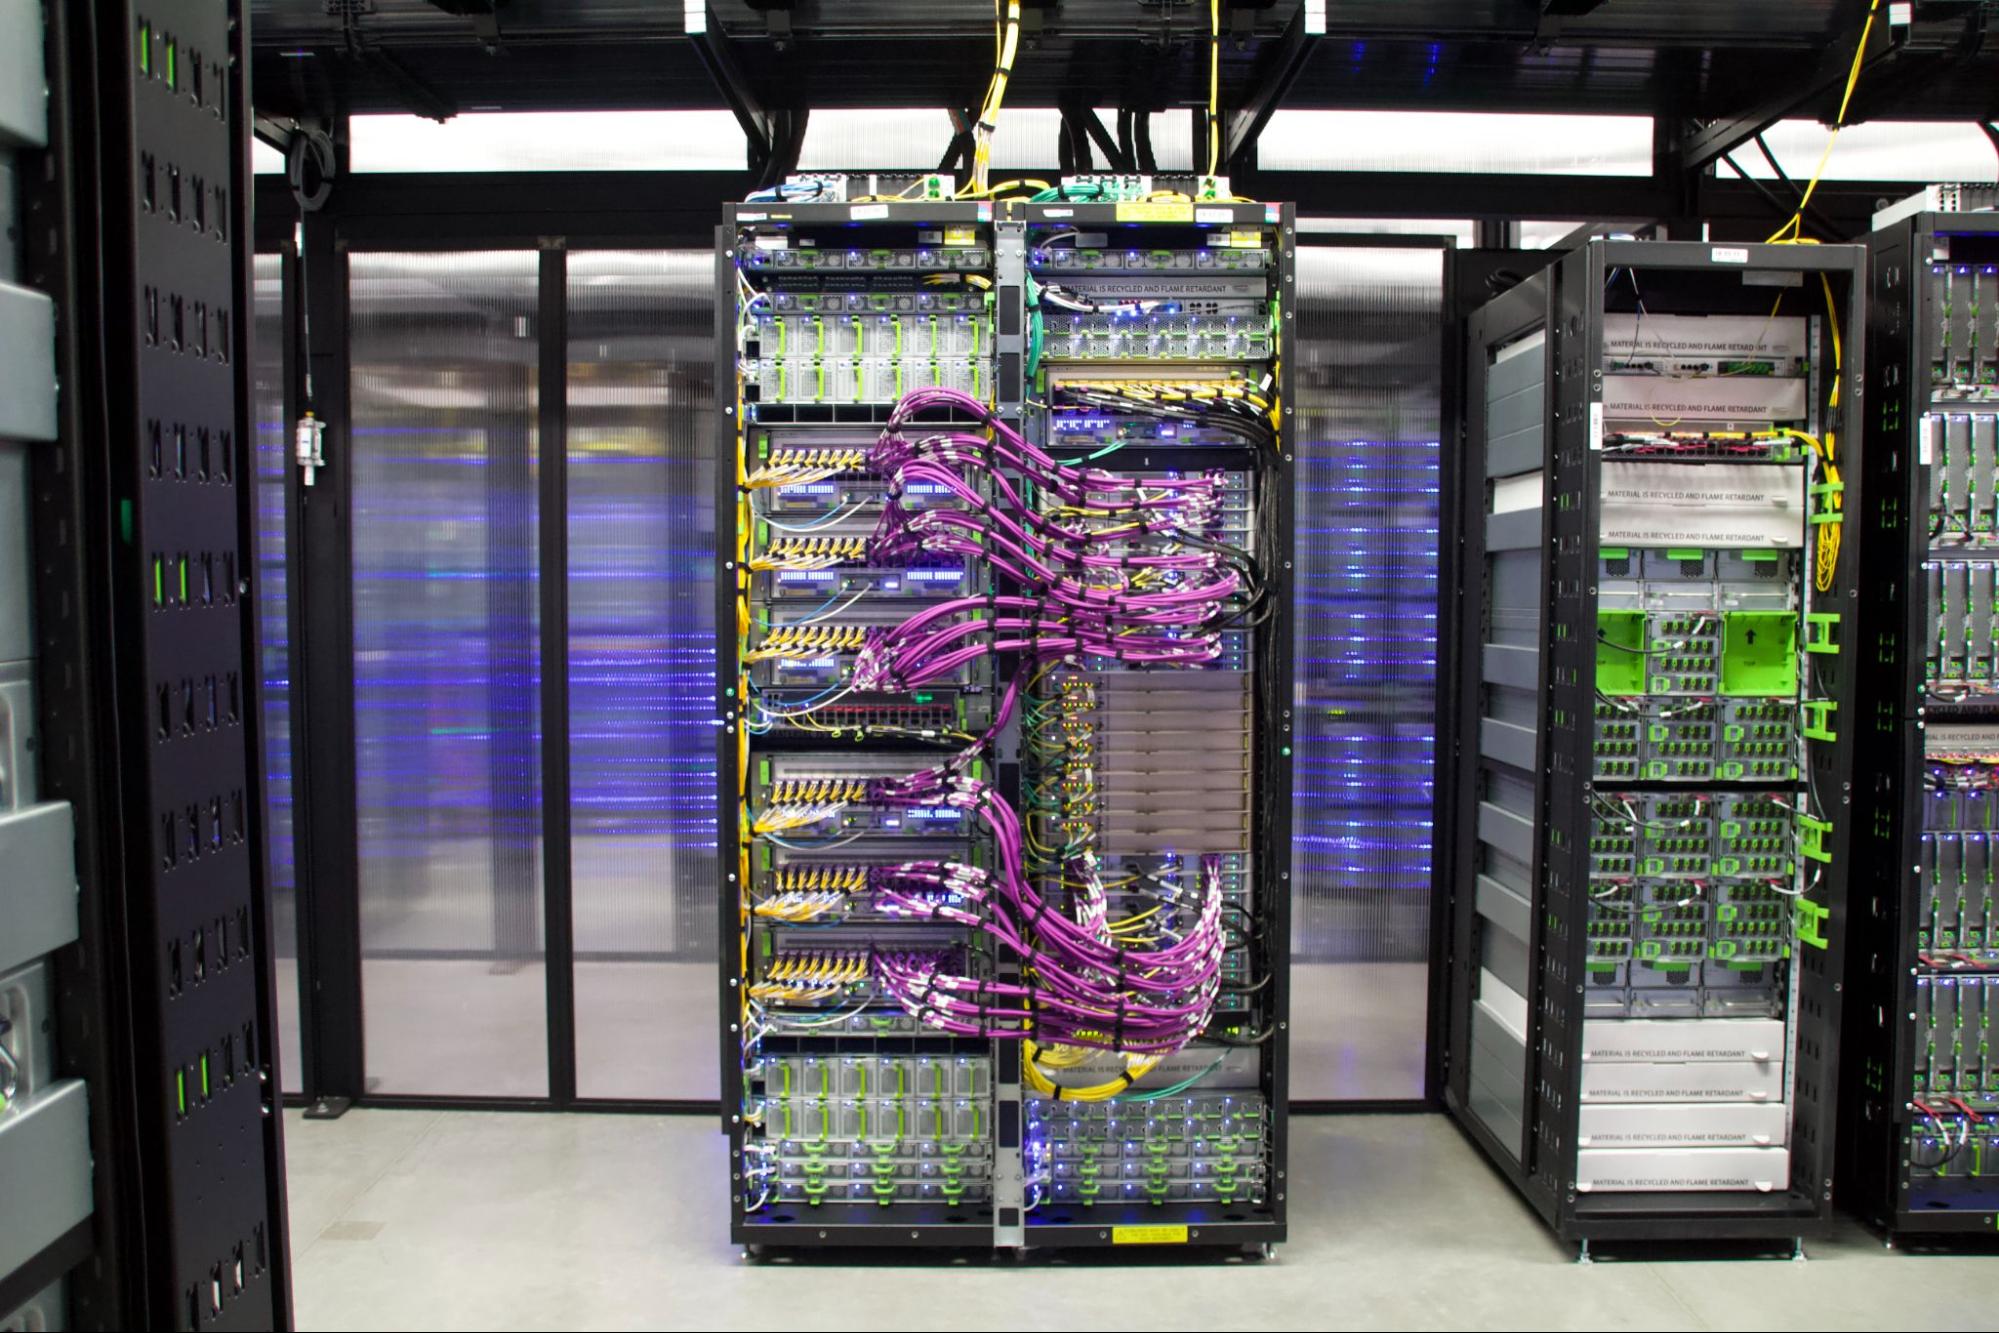
GPU внутри зданий и между ними связаны отдельной сетью Ethernet. Одна сетевая фабрика здания объединяет до 20 736 процессоров. На площадке проложены миллионы миль оптоволокна и стоят десятки тысяч коммутаторов.
Главная проблема — сбои
Чем больше кластер, тем чаще одна неисправная машина тормозит или останавливает всё обучение. В середине 2025 года число прерываний доходило почти до 1000 в сутки на каждые 8 тыс. GPU. За следующий год Meta сократила его на 99%. Цель компании — два прерывания в сутки на те же 8 тыс. процессоров.
Чтобы обучение не вставало, в каждой стойке работают 64 GPU, а ещё 8 держат в резерве. Около 2% стоек хранят про запас на случай полного отказа. Так, для обучения на 32 768 процессорах нужно 523 стойки, то есть на 13% больше оборудования.
Отдельная задача — питание. Каждый GPU под нагрузкой потребляет 1400 Вт. Запуск или пауза крупной задачи меняет потребление площадки на десятки мегаватт за секунды. Резкие скачки сглаживают аккумуляторы в стойках и накопители энергии на уровне всего объекта.
Prometheus будут расширять стойками GB300 и Vera Rubin. Следующий суперкластер Meta, Hyperion, строится в округе Ричленд-Пэриш в Луизиане. На Prometheus компания уже обучила модель Muse Wonder, свою первую флагманскую модель.
Источники: Engineering at Meta — устройство суперкластера Prometheus