DeepSeek открыла код движка, на котором работают её модели
К вечеру вторника репозиторий собрал больше 8 тыс. звёзд на GitHub, а разработчики vLLM пообещали перенять идеи DeepInfer.
Фото: Solen Feyissa / Unsplash
Китайская DeepSeek во вторник открыла исходный код DeepInfer — собственного фреймворка, на котором компания запускает свои ИИ-модели в рабочих сервисах. Код выложен на GitHub под лицензией Apache 2.0, поэтому его можно бесплатно использовать и в коммерческих продуктах. Пока движок поддерживает только модель DeepSeek-V4.1-Flash, которая вышла в сентябре.
«Представляем DeepInfer, наш внутренний фреймворк для инференса, теперь полностью открытый», — написала компания в X. Инференсом называют работу уже обученной модели, когда она отвечает на запросы пользователей. На этом этапе ИИ-компании тратят большую часть денег на вычисления.
Что внутри
- оптимизированные вычислительные ядра на основе открытых библиотек DeepSeek, включая FlashMLA, DeepGEMM и DeepEP;
- распределение модели между множеством чипов;
- спекулятивное декодирование: движок набрасывает несколько токенов вперёд и проверяет их за один проход, что ускоряет ответ;
- режим, в котором ответ не зависит от состава пакета запросов, и вывод в заданном формате, например по JSON-схеме.
Движок работает на серверных GPU Nvidia поколения SM100 и на китайских чипах Huawei Ascend 950. Поддержка Huawei заметна на фоне экспортных ограничений США. В начале октября DeepSeek уже публиковала инструменты для чипов Huawei как альтернативу платформе CUDA от Nvidia.
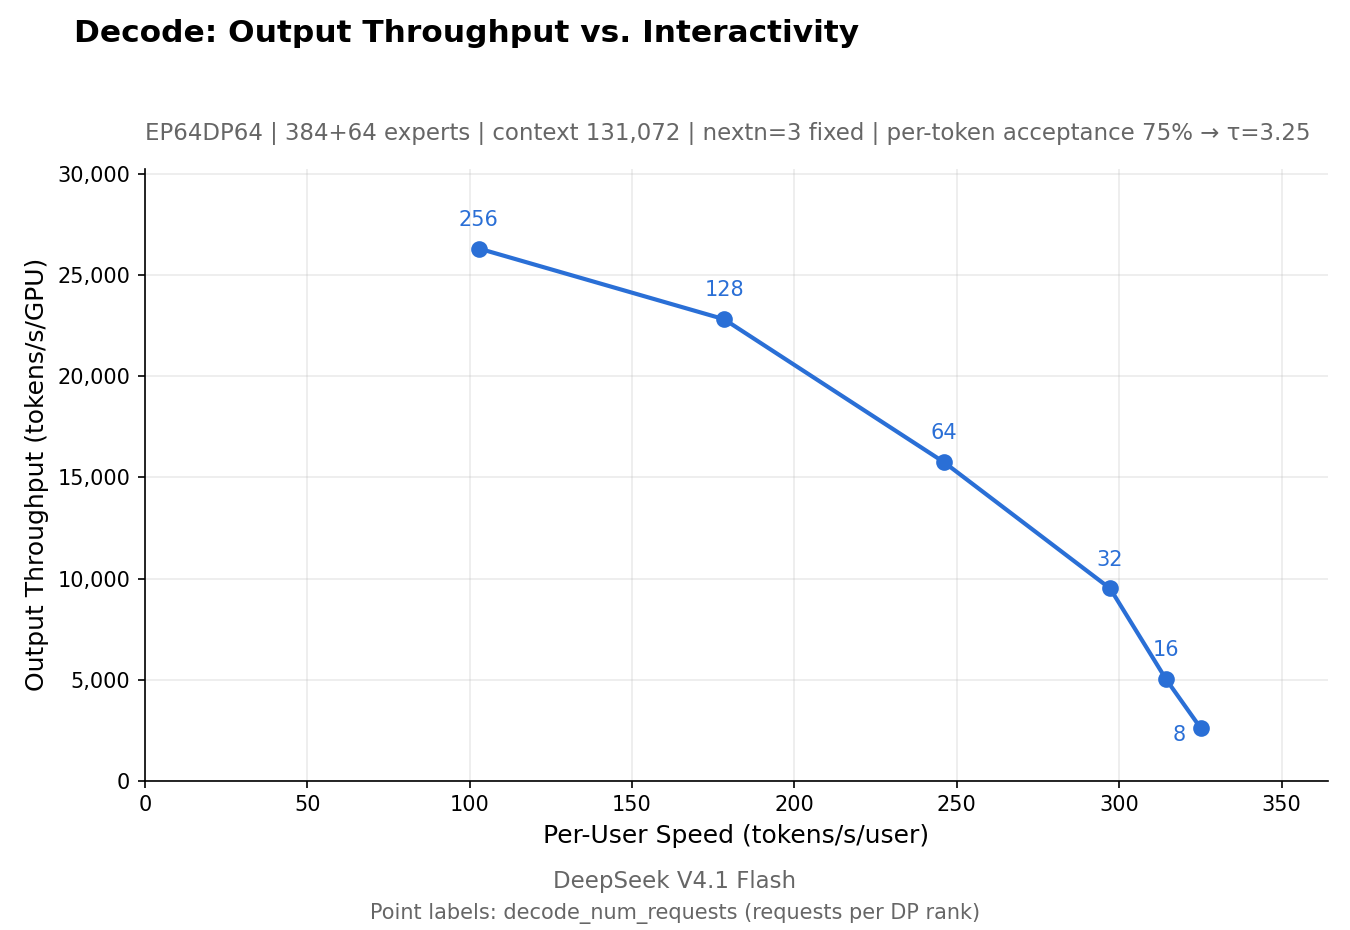
В релиз не вошли кэш промежуточных вычислений, разделение обработки запроса и генерации ответа, а также балансировка нагрузки между серверами. Поэтому DeepInfer пока не готовый сервис, а основа, которую придётся достраивать. Производительность DeepSeek показала на графиках: обработку запросов измеряли на 4 GPU, генерацию ответов — на 64. Независимой проверки этих результатов пока нет.
Изначально DeepInfer строили на базе открытого проекта vLLM с идеями из SGLang и TensorRT-LLM от Nvidia. Команда vLLM поблагодарила DeepSeek и пообещала использовать наработки, чтобы улучшить поддержку V4.1-Flash. Облачные провайдеры и компании, которые держат модели DeepSeek на своих серверах, теперь могут запускать их теми же методами, что и сама разработчица. Обычно ИИ-компании такие технологии не раскрывают.
Релиз вышел через день после того, как США запретили DeepSeek во всех гражданских федеральных ведомствах.
Источники: GitHub — репозиторий DeepInfer, The Next Web — о релизе DeepInfer