Meta миллион GPU-ге арналған суперкластерін көрсетті
Кластердегі бір GPU жүктеме кезінде 1400 Вт тұтынады, ал үлкен тапсырманы іске қосу не тоқтату тұтынуды бірнеше секундта ондаған мегаваттқа өзгертеді.
Фото: Meta
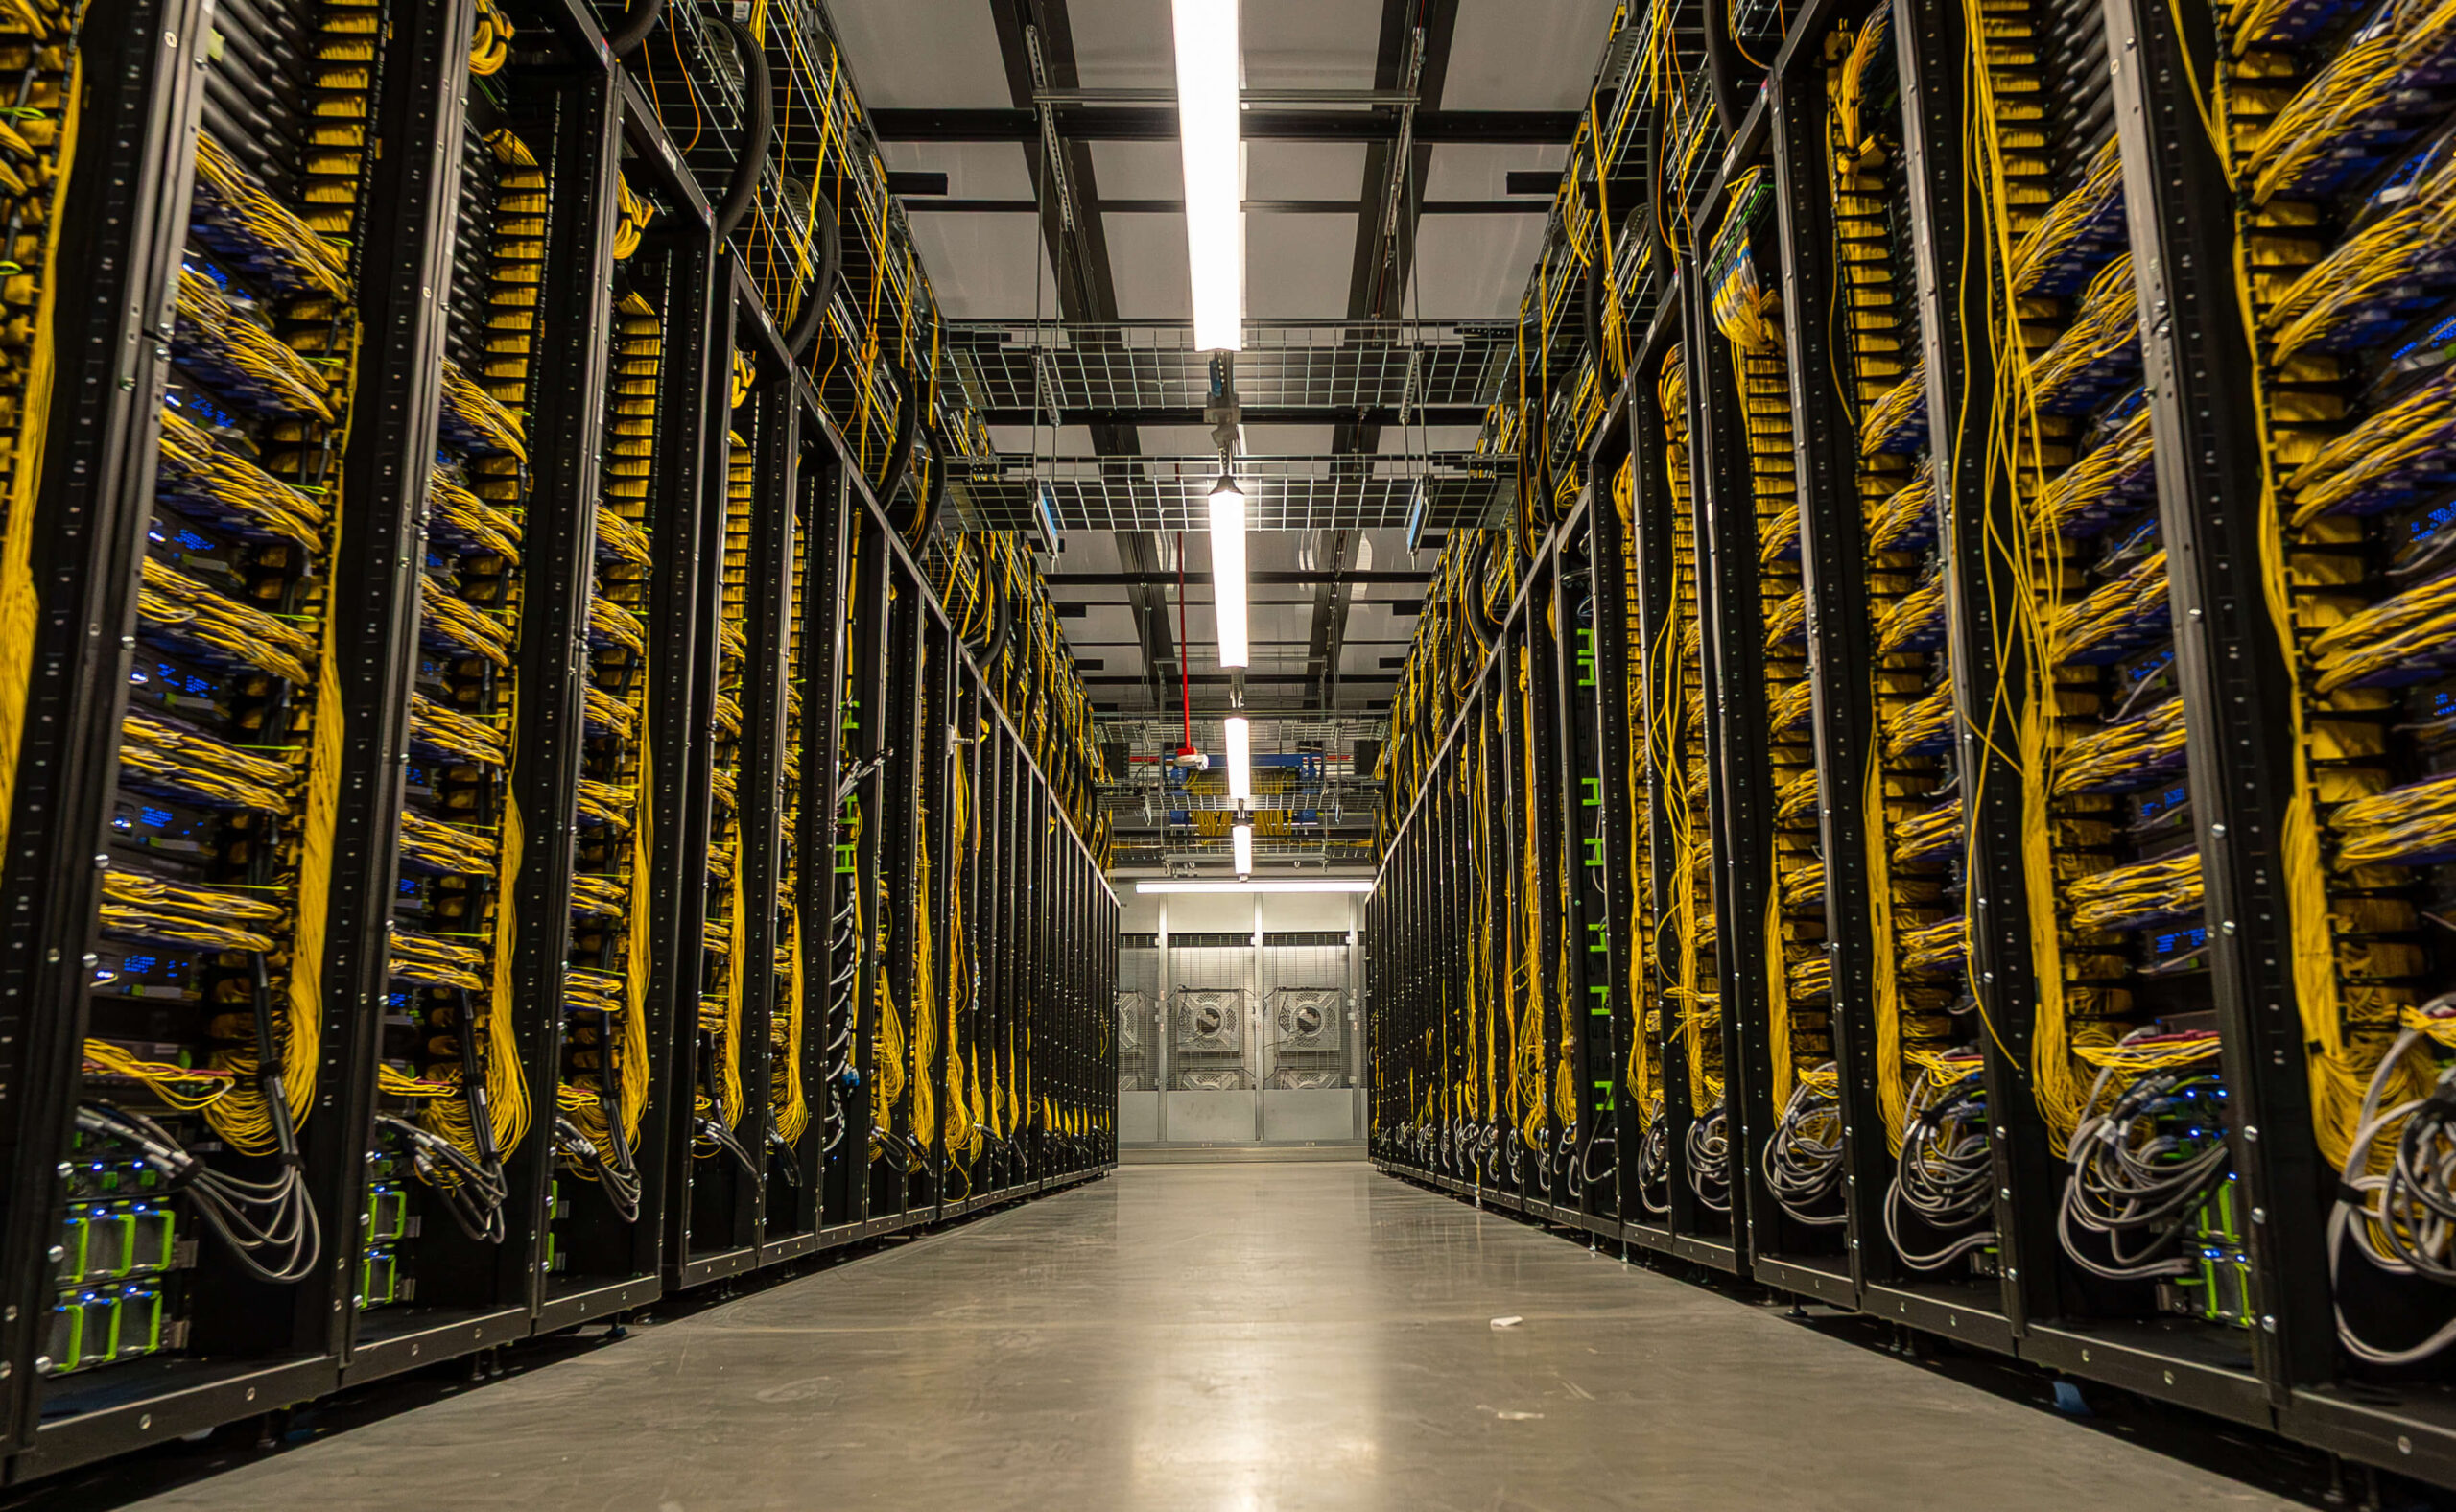
Meta жасанды интеллект оқытуға арналған Prometheus суперкластерін алғаш рет егжей-тегжейлі сипаттады. Кластер Огайо штатындағы Нью-Олбани қаласында орналасқан. Оның бірінші кезегі қазірдің өзінде жұмыс істеп тұр, онда Muse отбасының модельдері, соның ішінде флагмандық Muse Wonder оқытылған. Қазір кластерде бір-бірімен байланысқан бірнеше ғимаратта жүздеген мың графикалық процессор бар. Толық қуатына жеткенде олардың саны шамамен миллионға жетеді.
«Толық ауқымында Prometheus синхронды жұмыс істейтін шамамен миллион таратылған GPU-ден тұрады», деп жазады компания инженерлері Engineering at Meta блогында. Нысанның қуаты гигаваттпен өлшенеді. Екі жыл бұрын бұл жерде веб-трафикке арналған қарапайым дата-орталық тұрған.
Кластер неден құралған
Prometheus-тың негізі — 72 GPU-ге арналған Nvidia стойкалары. Алғашқы Catalina платформасы GB200 NVL72 негізінде жасалған: әр GPU-де 192 ГБ HBM3e жады бар, FP4 есептеулерінде қуаты 1440 петафлопсқа дейін жетеді. Екінші платформа Clemente GB300 NVL72 қолданады. Онда әр процессорда 288 ГБ жады бар, ал өнімділігі бір экзафлопстан асады. Meta бағалауынша, ол GB200-ден 5–10% жылдам.
Келесі кезек — Nvidia Vera Rubin NVL72 негізіндегі San Miguel платформасы. Онда әр GPU-де 288 ГБ HBM4 жады болады, ал бір стойка FP4-те 2,52 экзафлопс береді. Meta дерегінше, энергия тиімділігі GB300-ге қарағанда 10–20% артады. Алайда бір стойка 170 кВт-тан астам қуат тұтынады.
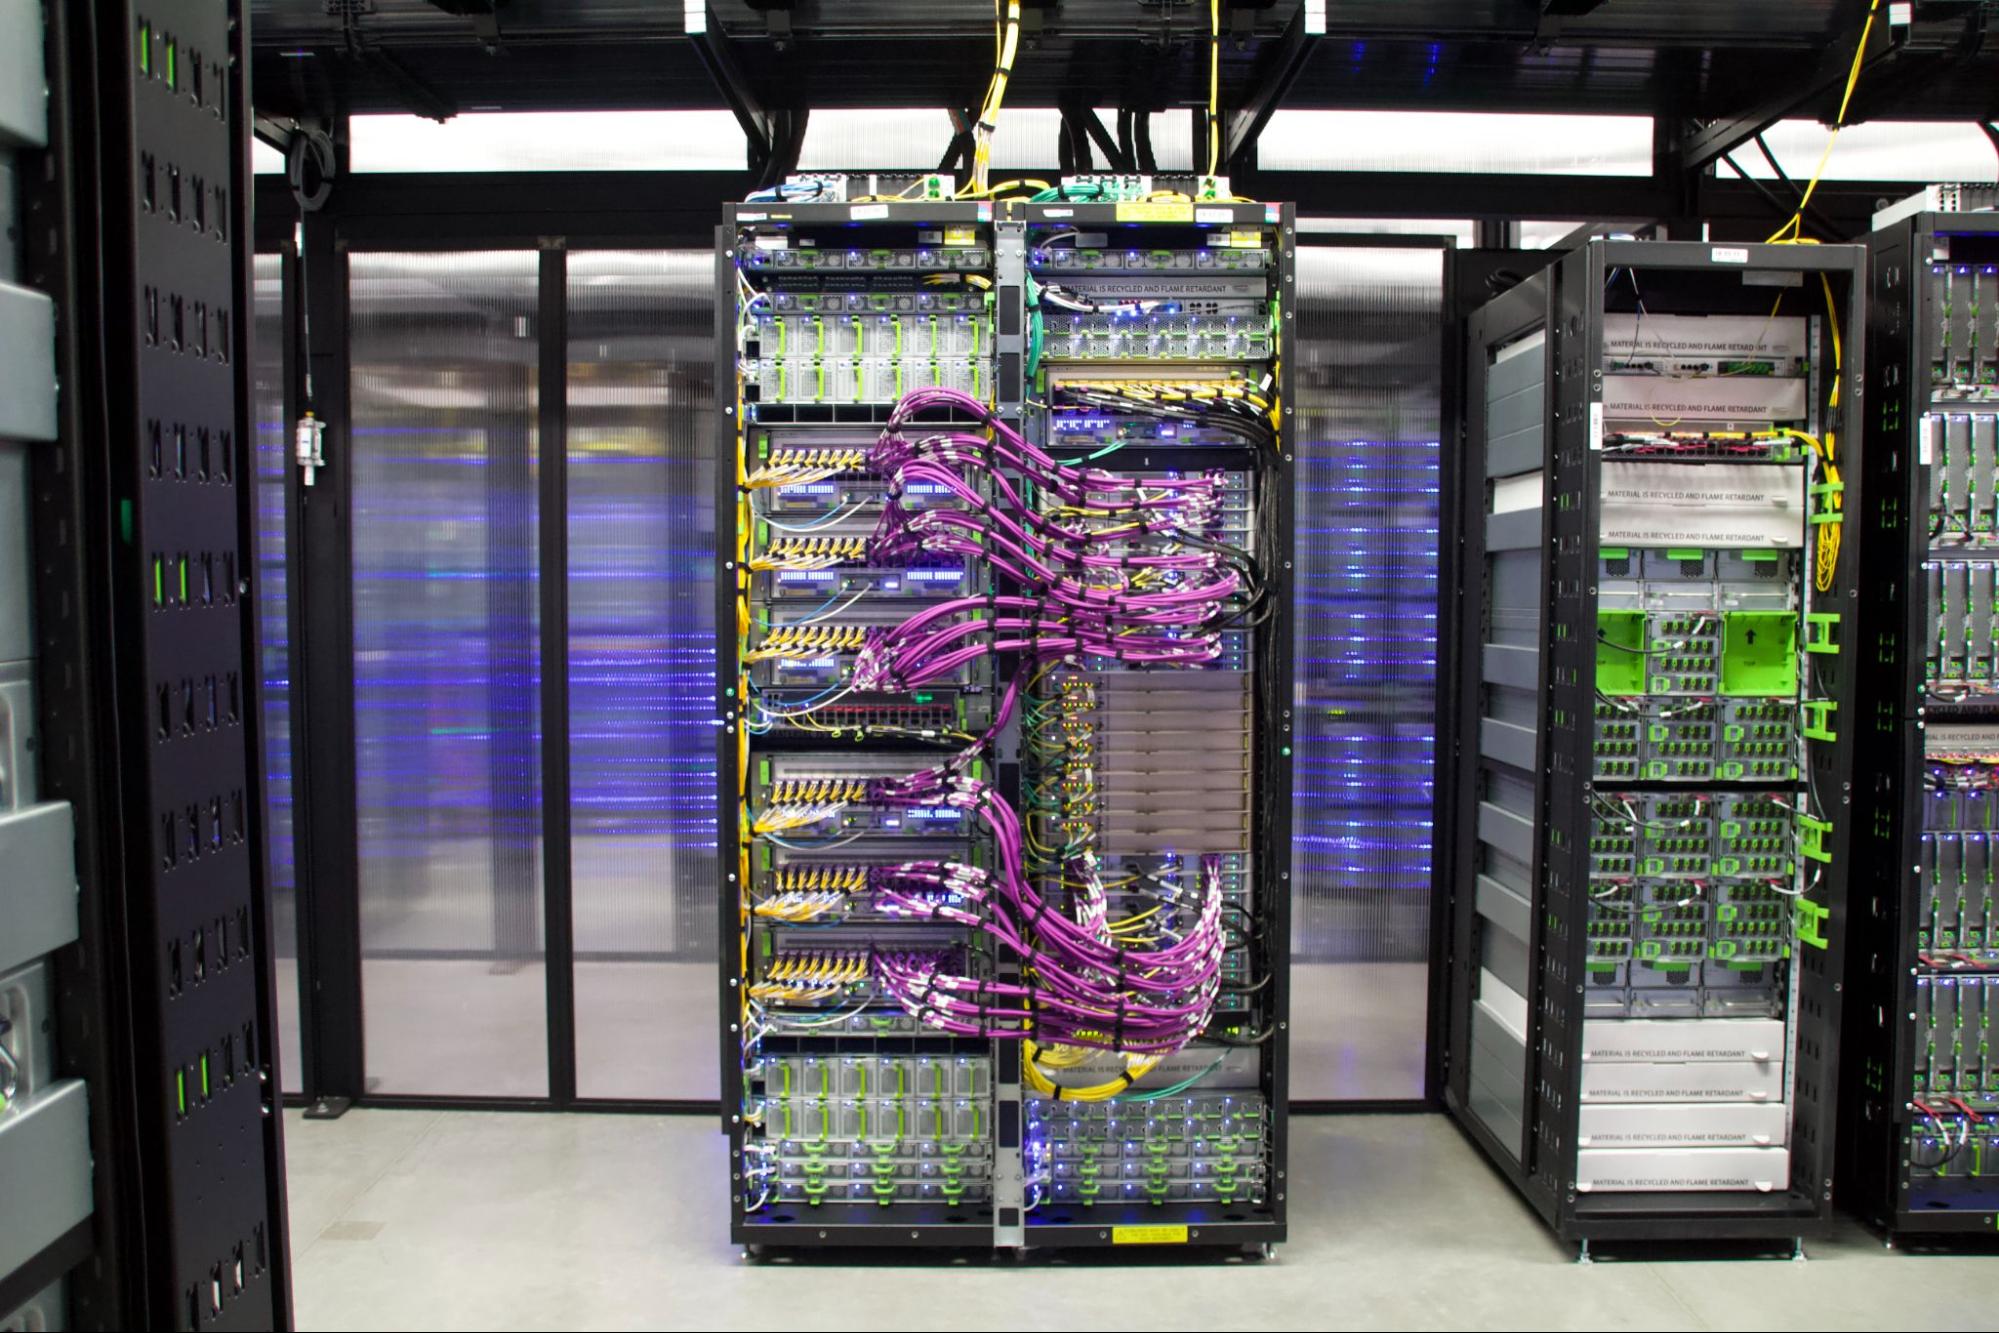
Ғимарат ішіндегі және ғимараттар арасындағы GPU-лер бөлек Ethernet желісімен байланысқан. Бір ғимараттың желілік фабрикасы 20 736 процессорға дейін біріктіреді. Нысанға миллиондаған миль оптоталшық тартылып, ондаған мың коммутатор орнатылған.
Басты мәселе — іркілістер
Кластер неғұрлым үлкен болса, бір ақаулы машина бүкіл оқытуды соғұрлым жиі баяулатады немесе тоқтатады. 2025 жылдың ортасында әр 8 мың GPU-ге тәулігіне 1000-ға жуық іркіліс келетін. Келесі бір жылда Meta бұл санды 99%-ға қысқартты. Компанияның мақсаты — сол 8 мың процессорға тәулігіне екі іркіліс.
Оқыту тоқтап қалмас үшін әр стойкада 64 GPU жұмыс істейді, ал тағы 8-і қорда тұрады. Стойка толық істен шыққан жағдайға стойкалардың шамамен 2%-ы сақтық ретінде ұсталады. Мәселен, 32 768 процессормен оқыту үшін 523 стойка керек, яғни жабдық 13%-ға көп жұмсалады.
Қуат беру де бөлек міндет. Әр GPU жүктеме кезінде 1400 Вт тұтынады. Үлкен тапсырманы іске қосу не тоқтату нысанның тұтынуын бірнеше секундта ондаған мегаваттқа өзгертеді. Мұндай секірістерді стойкалардағы аккумуляторлар мен бүкіл нысан деңгейіндегі энергия жинақтағыштар тегістейді.
Prometheus GB300 және Vera Rubin стойкаларымен кеңейтіледі. Meta-ның келесі Hyperion суперкластері Луизианадағы Ричленд-Пэриш округінде салынып жатыр. Prometheus-та компания өзінің алғашқы флагмандық Muse Wonder моделін оқытып үлгерді.
Дереккөздер: Engineering at Meta — Prometheus суперкластерінің құрылымы